Cómo el Big Data está revolucionando el sector salud
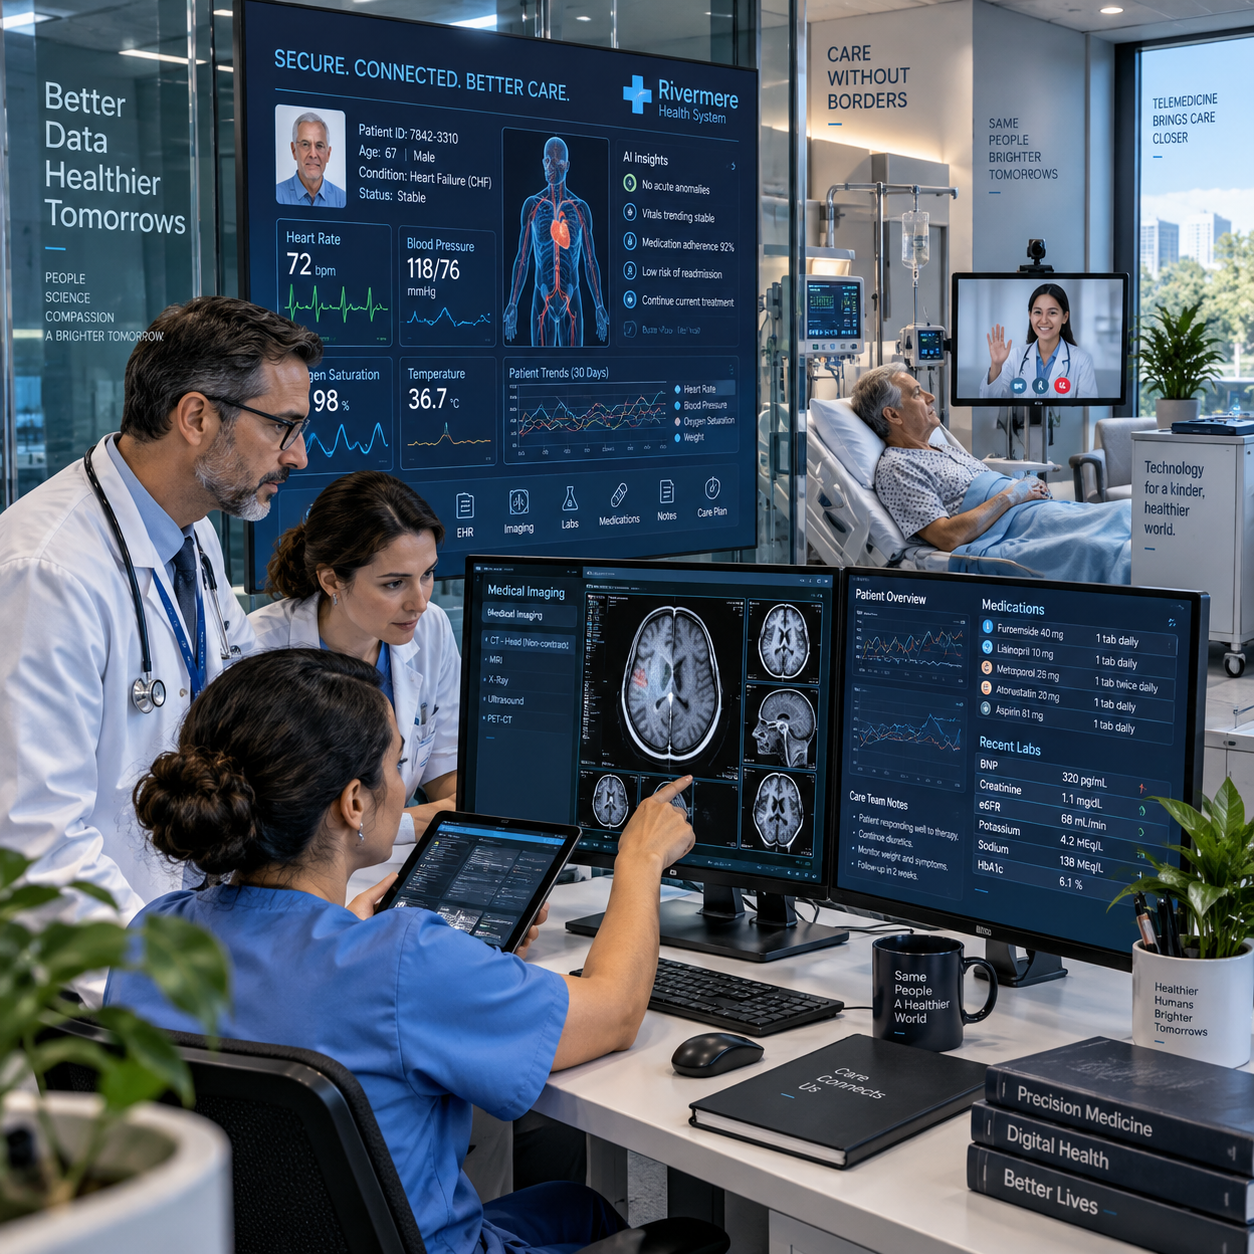
La atención sanitaria genera información en cada consulta, prueba diagnóstica y seguimiento. El Big Data en salud permite reunir y analizar parte de esos datos para detectar patrones, apoyar decisiones clínicas y organizar mejor los servicios. Su valor depende tanto de la tecnología como de la calidad de la información, la protección de los pacientes y el criterio de los profesionales.
Qué significa Big Data en el ámbito sanitario
El Big Data en el ámbito sanitario consiste en gestionar y analizar grandes volúmenes de datos de salud, diversos y generados a distintas velocidades, para obtener información útil. Puede integrar registros clínicos, resultados de laboratorio y datos de dispositivos, siempre bajo controles adecuados de acceso y uso.
Entre las fuentes habituales están las historias clínicas electrónicas, las imágenes médicas, las recetas, los datos de laboratorio y los registros administrativos. También pueden incorporarse información de salud pública, consultas de telemedicina y mediciones de dispositivos portátiles, como actividad o frecuencia cardiaca. Cada fuente tiene distintos niveles de precisión y contexto; un dato aislado no equivale a una conclusión clínica.
La analítica de datos puede describir lo ocurrido, ayudar a explicar patrones y estimar qué situaciones podrían requerir atención. Para combinar fuentes, hace falta que los sistemas puedan intercambiar información y que esta conserve su significado. Por eso la interoperabilidad y la gobernanza de datos son parte central del Big Data, no tareas técnicas secundarias.
Aplicaciones del Big Data en la atención médica
El Big Data ayuda a detectar patrones clínicos, orientar la prevención y adaptar el seguimiento a las necesidades de cada paciente. Sus aplicaciones abarcan el diagnóstico, la planificación de cuidados y la continuidad de la atención, aunque sus resultados deben validarse en el contexto clínico.
En diagnóstico, los sistemas pueden comparar datos actuales con grandes conjuntos de casos previos o ayudar a priorizar imágenes que necesitan revisión. Un modelo puede señalar una anomalía potencial; el profesional verifica el resultado junto con síntomas, antecedentes y pruebas. Así, el análisis funciona como apoyo, no como diagnóstico autónomo.
En prevención, el diagnóstico predictivo puede identificar grupos con mayor probabilidad de necesitar seguimiento, por ejemplo, pacientes con enfermedades crónicas que han faltado a controles. Esa señal permite ofrecer una llamada o una cita, pero no prueba que una persona vaya a enfermar. La utilidad depende de que el modelo sea preciso y no perjudique de forma sistemática a ciertos grupos.
La medicina personalizada también aprovecha datos clínicos para ajustar decisiones a las características y antecedentes de cada paciente. Combinada con telemedicina, puede facilitar el seguimiento entre consultas, siempre que haya protocolos claros para responder ante cambios preocupantes y alternativas para quienes no tienen acceso digital.
Beneficios para pacientes y organizaciones sanitarias
El análisis de datos puede mejorar la coordinación de la atención y ayudar a instituciones sanitarias a asignar recursos con más información. Para pacientes y profesionales, el beneficio aparece cuando los datos relevantes llegan a tiempo y se integran en decisiones comprensibles.
En la atención individual, una historia clínica más completa puede reducir la repetición de preguntas o pruebas y facilitar la continuidad cuando intervienen varios equipos. El personal clínico puede revisar antecedentes, medicación y resultados desde una vista más ordenada. Sin integración fiable, en cambio, los datos duplicados o desactualizados pueden añadir confusión.
En la gestión hospitalaria, la analítica ayuda a estimar demanda, planificar turnos, administrar camas y vigilar inventarios. Por ejemplo, los registros de ocupación y admisiones pueden mostrar periodos de presión para que un hospital revise sus calendarios y recursos. Es una ayuda para planificar, no una garantía de que la demanda futura coincida con la estimación.
Las organizaciones deben valorar los beneficios junto con sus costes: integración de sistemas, mantenimiento, capacitación y revisión de resultados. Medir tiempos de espera, duplicación de pruebas o calidad de seguimiento antes y después de un cambio ofrece una evaluación más sólida que contar únicamente cuántos datos se recopilan.
El papel de la inteligencia artificial y la analítica predictiva
La inteligencia artificial y la analítica predictiva complementan el Big Data al encontrar patrones y estimar riesgos a partir de datos disponibles. No reemplazan el juicio clínico: sus resultados requieren interpretación, supervisión y una vía clara para corregir errores.
La inteligencia artificial puede procesar imágenes, texto clínico o señales de dispositivos; los modelos predictivos, por su parte, calculan probabilidades según variables seleccionadas. Por ejemplo, una herramienta podría marcar historias que conviene revisar antes de una consulta. El equipo debe conocer qué datos sustentan la alerta y qué limitaciones tiene.
Un riesgo común es confundir una correlación con una causa. También puede cambiar el rendimiento cuando el modelo se usa en una población distinta de aquella con la que se desarrolló. Por eso conviene comprobar su precisión por grupos, revisar alertas incorrectas y monitorizar el desempeño después de implementarlo. La decisión final debe considerar el contexto y las preferencias del paciente.
Retos de privacidad, seguridad e interoperabilidad
Los principales retos del Big Data sanitario son proteger información sensible, evitar usos no autorizados y lograr que sistemas distintos intercambien datos de forma segura y comprensible. Una solución necesita controles técnicos y reglas organizativas desde su diseño.
Los datos de salud pueden revelar diagnósticos, tratamientos y otros aspectos íntimos. Las instituciones deben limitar el acceso según funciones, cifrar la información, registrar consultas y definir cuánto tiempo conservarla. La anonimización puede reducir riesgos, aunque no siempre elimina la posibilidad de reidentificar a alguien al combinar conjuntos de datos.
La interoperabilidad también es compleja: dos sistemas pueden usar formatos distintos o asignar significados diferentes a un mismo campo. Para mejorarla, se necesitan estándares, diccionarios de datos compartidos y pruebas de intercambio que confirmen que la información llega completa y correctamente interpretada. Además, deben establecerse responsabilidades ante fallos, incidentes de seguridad o datos erróneos.
Antes de analizar información para investigación o nuevos usos, la organización debe determinar la base legal aplicable, informar a las personas cuando corresponda y consultar requisitos regulatorios locales. El consentimiento, la minimización de datos y la revisión ética no se sustituyen con una herramienta tecnológica.
Cómo implementar soluciones de Big Data en salud
Para implementar Big Data en salud, una organización debe definir un problema concreto, evaluar sus datos y sistemas, establecer salvaguardas y medir resultados con participación clínica. Empezar con un caso de uso acotado permite aprender antes de ampliar la solución.
- Precisar el objetivo: elegir una necesidad medible, como reducir demoras en el seguimiento o mejorar la planificación de camas, y fijar una línea de base.
- Revisar los datos: comprobar exactitud, actualidad, duplicados, campos faltantes y representatividad de las poblaciones atendidas.
- Diseñar la arquitectura: definir cómo se integrarán historias clínicas electrónicas, laboratorios y otros sistemas, quién podrá acceder y cómo se protegerá la información.
- Probar con supervisión: realizar un piloto con profesionales y pacientes pertinentes, revisar resultados y errores, y mantener una alternativa manual si la herramienta falla.
- Evaluar y ajustar: medir utilidad clínica, impacto operativo, equidad, seguridad y coste total; ampliar solo si la evidencia local lo justifica.
Una equivocación frecuente es comprar primero una plataforma y buscar después el problema que resolverá. Esto suele crear integraciones costosas y poco uso. También conviene evitar modelos opacos que el equipo no pueda cuestionar. Las soluciones de Big Data aportan valor cuando encajan en el flujo de trabajo, cuentan con responsables definidos y se revisan durante toda su vida útil.
Preguntas frecuentes sobre Big Data en salud
Estas respuestas resumen qué información se analiza, cómo puede apoyar la medicina personalizada y qué responsabilidades mantienen hospitales y profesionales. El uso concreto depende de la calidad de los datos y de las normas aplicables.
¿Qué tipos de datos se utilizan en el Big Data sanitario?
Se utilizan historias clínicas electrónicas, diagnósticos, pruebas de laboratorio, imágenes, recetas, datos administrativos y mediciones de dispositivos. También pueden incluirse registros de telemedicina o información de salud pública, con criterios de seguridad y pertinencia.
¿Cómo ayuda el Big Data a personalizar los tratamientos?
Permite reunir antecedentes y características clínicas para que el equipo valore opciones más adecuadas a cada persona. El análisis orienta; la elección del tratamiento requiere evaluación profesional y conversación con el paciente.
¿Qué riesgos de privacidad plantea el análisis de datos de salud?
Puede exponer información sensible por accesos indebidos, filtraciones o reidentificación de datos supuestamente anónimos. Limitar la recopilación y los permisos, proteger los sistemas y auditar su uso reduce esos riesgos, aunque no los elimina por completo.
¿Qué papel tienen los hospitales y los profesionales en su implementación?
Los hospitales definen objetivos, gobernanza, infraestructura y controles de seguridad. Los profesionales ayudan a elegir casos de uso, validar alertas y mantener la decisión clínica bajo supervisión humana; su participación también permite detectar fallos que una evaluación puramente técnica podría pasar por alto.