Implementación de soluciones en la nube para el manejo de datos: guía práctica
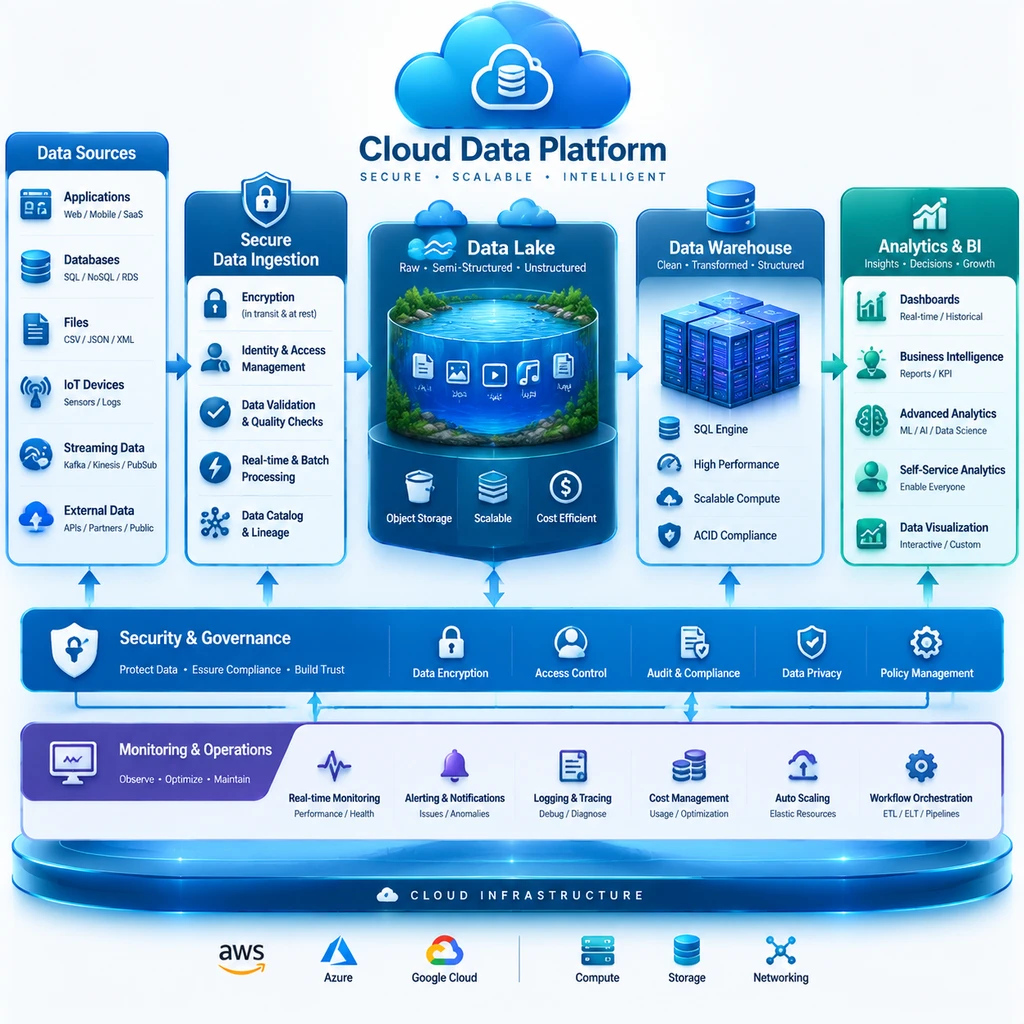
La implementación de soluciones en la nube para el manejo de datos permite almacenar, procesar e integrar información con recursos que pueden crecer según la demanda. Para que una plataforma de big data aporte valor, hay que elegir la arquitectura según los casos de uso y diseñar desde el inicio la seguridad, la gobernanza y el control de costes.
Migrar datos sin evaluar su calidad, sensibilidad o forma de uso suele trasladar los problemas existentes a otro entorno. Una planificación por etapas ayuda a reducir ese riesgo y a comprobar cada decisión antes de ampliar la solución.
Definir objetivos y requisitos de gestión de datos
Antes de elegir servicios, defina qué decisiones o procesos debe mejorar la plataforma y qué datos necesita para hacerlo. El volumen, la variedad, la velocidad y la sensibilidad de la información determinan los requisitos de almacenamiento, procesamiento, acceso y protección.
Empiece por casos de uso concretos: consolidar informes comerciales, analizar eventos de aplicaciones o detectar anomalías en operaciones. Para cada uno, identifique quién utilizará los resultados, con qué frecuencia y qué demora es aceptable. Un informe diario puede tolerar procesamiento por lotes; una alerta operativa quizá requiera una canalización casi en tiempo real.
También conviene clasificar las fuentes y los datos. Registros estructurados de una base de datos, documentos, imágenes y flujos de sensores plantean necesidades distintas. Añada requisitos de retención, residencia, disponibilidad y cumplimiento normativo. La información personal o financiera exige controles más estrictos que un conjunto de datos público.
- Volumen: cantidad actual y crecimiento esperado.
- Variedad: formatos, esquemas y sistemas de origen.
- Velocidad: frecuencia de llegada y tiempo disponible para procesar.
- Sensibilidad: impacto de una exposición, alteración o pérdida.
El resultado práctico es una lista priorizada de requisitos, no una meta vaga como “llevar todo a la nube”. Así se puede decidir qué migrar primero y qué conviene mantener temporalmente en los sistemas existentes.
Elegir la arquitectura y los servicios en la nube
La arquitectura adecuada combina almacenamiento, procesamiento e integración según el uso previsto; no existe una configuración única para todos los proyectos de big data. La elección entre lago de datos, almacén de datos y enfoques híbridos depende de los formatos, los usuarios y la rapidez con que se necesiten resultados.
Un lago de datos (data lake) conserva grandes volúmenes de datos en formatos diversos, incluidos datos sin transformar. Ofrece flexibilidad para exploración y ciencia de datos, pero requiere catálogo, controles de calidad y convenciones claras para evitar que se convierta en un repositorio difícil de entender. Un almacén de datos (data warehouse) organiza información preparada para consultas y análisis consistentes. Suele facilitar la elaboración de informes, aunque puede exigir transformar los datos antes de cargarlos.
Muchas organizaciones usan ambos: el lago conserva los datos de origen y el almacén sirve conjuntos depurados a analistas y equipos de negocio. La computación en la nube permite aprovisionar recursos de almacenamiento y cómputo de forma separada en muchos servicios, pero esa elasticidad no garantiza costes bajos: el consumo, las consultas y la transferencia de datos también se facturan según el proveedor y el contrato.
Para comparar opciones, trace una ruta de extremo a extremo:
- Almacenamiento: evalúe formatos, durabilidad, ciclo de vida y acceso frecuente o infrecuente.
- Procesamiento de datos: determine si necesita lotes, flujos, consultas SQL o aprendizaje automático.
- Integración de datos: revise conectores, API, replicación y compatibilidad con sistemas locales.
Elija servicios administrados cuando reduzcan tareas operativas que el equipo no necesita controlar. Si se prioriza portabilidad o control detallado, una arquitectura más abierta puede ser preferible, aunque normalmente demanda más mantenimiento especializado.
Diseñar la migración y la integración de datos
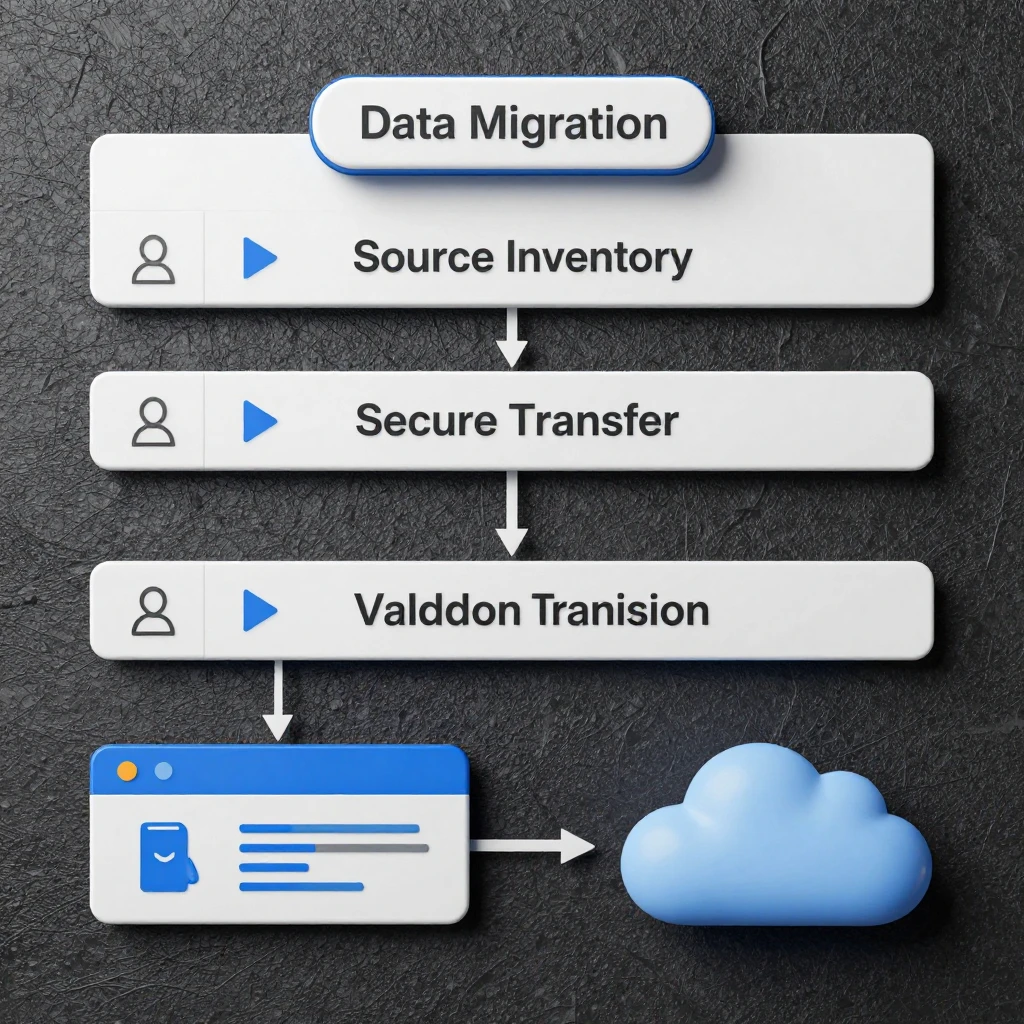
Una migración segura comienza con un inventario de fuentes, dependencias, propietarios y calidad de datos. Después se planifican la transferencia, la transformación y las pruebas para que la información llegue completa y pueda utilizarse en los sistemas de destino.
Registre bases de datos, aplicaciones, archivos y flujos; para cada fuente, anote su volumen, formato, frecuencia de actualización y responsable. Identifique dependencias, como informes que consumen una tabla o procesos que esperan un archivo con un nombre específico. Este mapa ayuda a ordenar la migración y a evitar interrupciones inesperadas.
Seleccione el método según el tamaño y la conectividad: una transferencia inicial puede ir seguida de cargas incrementales, mientras que una base con cambios continuos puede necesitar replicación controlada. En ambos casos, defina cómo resolver errores, duplicados y diferencias de esquema. Mantenga un plan de reversión para los sistemas críticos y no retire el entorno anterior hasta validar el nuevo.
La calidad se comprueba con reglas verificables: conteos de registros, campos obligatorios, rangos válidos y conciliación de totales entre origen y destino. También conviene probar casos límite, como fechas faltantes o códigos desconocidos. Un conjunto migrado puede estar técnicamente completo y aun así resultar inservible si cambió el significado de sus campos.
Proteger y gobernar los datos desde el inicio
La seguridad y la gobernanza deben formar parte del diseño, desde la ingesta hasta el acceso analítico. Clasificar los datos, limitar permisos y documentar su uso reduce el riesgo de exposición y facilita demostrar quién accedió a qué información.
Use el principio de mínimo privilegio: cada persona y servicio recibe solo los permisos necesarios para su función. Separe entornos de desarrollo y producción, gestione credenciales de forma segura y revise periódicamente las cuentas y roles. El cifrado en tránsito y en reposo es una medida importante, pero no sustituye la gestión de claves, el control de acceso ni la vigilancia de actividad.
La gobernanza convierte reglas en prácticas operativas. Mantenga un catálogo con descripciones, propietarios, linaje y nivel de sensibilidad de los conjuntos de datos. Defina políticas de retención, eliminación, uso aceptable y anonimización cuando corresponda. Los requisitos específicos dependen del país, el sector y la naturaleza de la información; por eso, legal, seguridad y responsables del dato deben validar las obligaciones aplicables.
Un error frecuente es conceder acceso amplio para acelerar el piloto y dejarlo sin revisar. Es comprensible mientras se prueba una solución, pero puede exponer datos sensibles al pasar a producción. Establezca desde el inicio una fecha de caducidad para permisos temporales y registre las excepciones.
Implementar, probar y optimizar la solución
Implemente la solución de forma gradual: pruebe una carga representativa, valide el resultado y amplíe el alcance solo cuando se cumplan los criterios acordados. La monitorización de calidad, rendimiento y consumo permite corregir problemas antes de que afecten a más usuarios.
Una secuencia útil es comenzar con un caso de uso de valor claro y riesgo controlable. Configure la ingesta y el almacenamiento, aplique transformaciones, y conecte un grupo pequeño de usuarios. Antes de producción, compruebe permisos, recuperación ante fallos, tiempos de procesamiento y resultados frente a la fuente original.
Defina alertas para fallos de canalización, retrasos, cambios inesperados en el volumen y consultas que consuman recursos fuera de lo previsto. Revise periódicamente el uso real: datos que nadie consulta quizá deban pasar a una capa de almacenamiento de menor coste, mientras que procesos lentos pueden requerir optimizar particiones o transformaciones. Las acciones concretas dependen del servicio; mida antes de aumentar capacidad.
Para controlar los costes en la nube, asigne etiquetas por equipo o proyecto, establezca presupuestos y examine cargos de cómputo, almacenamiento y transferencia. La escalabilidad facilita responder a picos, pero mantener recursos sobredimensionados o duplicar datos innecesariamente elimina parte de esa ventaja. No optimice solo la factura: una reducción de costes que empeore la disponibilidad o retrase decisiones puede salir cara al negocio.
Medir resultados y planificar la evolución
El éxito se mide con indicadores vinculados al caso de uso: disponibilidad, tiempo de procesamiento, calidad de datos, adopción y valor para el negocio. Revise una línea base anterior a la implementación para distinguir mejoras reales de impresiones.
Por ejemplo, un equipo que centraliza datos de ventas puede medir cuánto tarda en producir un informe, cuántos registros superan las validaciones y cuántos usuarios consultan los indicadores. Para una canalización operativa, pueden ser más relevantes la latencia, la tasa de fallos y el tiempo de recuperación. Acordar objetivos de nivel de servicio ayuda a que negocio y tecnología compartan expectativas.
Revise los indicadores en ciclos regulares y convierta los problemas observados en una hoja de ruta: mejorar una fuente de baja calidad, automatizar una tarea manual o incorporar otro caso de uso. La plataforma debe evolucionar con el volumen, las reglas de gobernanza y las necesidades de sus usuarios. No es necesario migrarlo todo a la vez; ampliar de forma controlada suele hacer más visibles los costes y los riesgos.
Preguntas frecuentes
Estas respuestas resumen las decisiones que más influyen en una implementación de big data en la nube: qué evaluar antes de migrar, qué arquitectura elegir y cómo proteger la información.
¿Qué conviene evaluar antes de migrar datos a la nube?
Revise casos de uso, fuentes, volumen, formatos, calidad, sensibilidad, dependencias y requisitos legales. Añada conectividad, costes estimados y un plan de reversión para sistemas críticos. Con esa información podrá priorizar una migración piloto y fijar criterios para aprobarla.
¿Cómo elegir entre un data lake y un data warehouse?
Elija un data lake cuando necesite conservar datos variados y explorar usos futuros; elija un data warehouse cuando priorice datos estructurados y consultas analíticas consistentes. Si necesita ambas funciones, pueden coexistir con una integración y una gobernanza bien definidas.
¿Cómo proteger los datos durante la migración y el almacenamiento?
Cifre las transferencias, limite el acceso a operadores autorizados, proteja las credenciales y valide los datos en destino. En almacenamiento, aplique permisos mínimos, cifrado, registro de actividad y políticas de retención. Pruebe los controles antes de mover información sensible.
¿Qué retos suelen aparecer al implementar una plataforma de big data en la nube?
Los más habituales son datos de baja calidad, sistemas difíciles de integrar, permisos excesivos, falta de conocimientos especializados y costes imprevistos. Un inventario temprano, pilotos acotados, responsables claros y monitorización continua ayudan a tratarlos antes de que afecten a la operación.