Introducción a Hadoop y Spark para principiantes: diferencias y usos
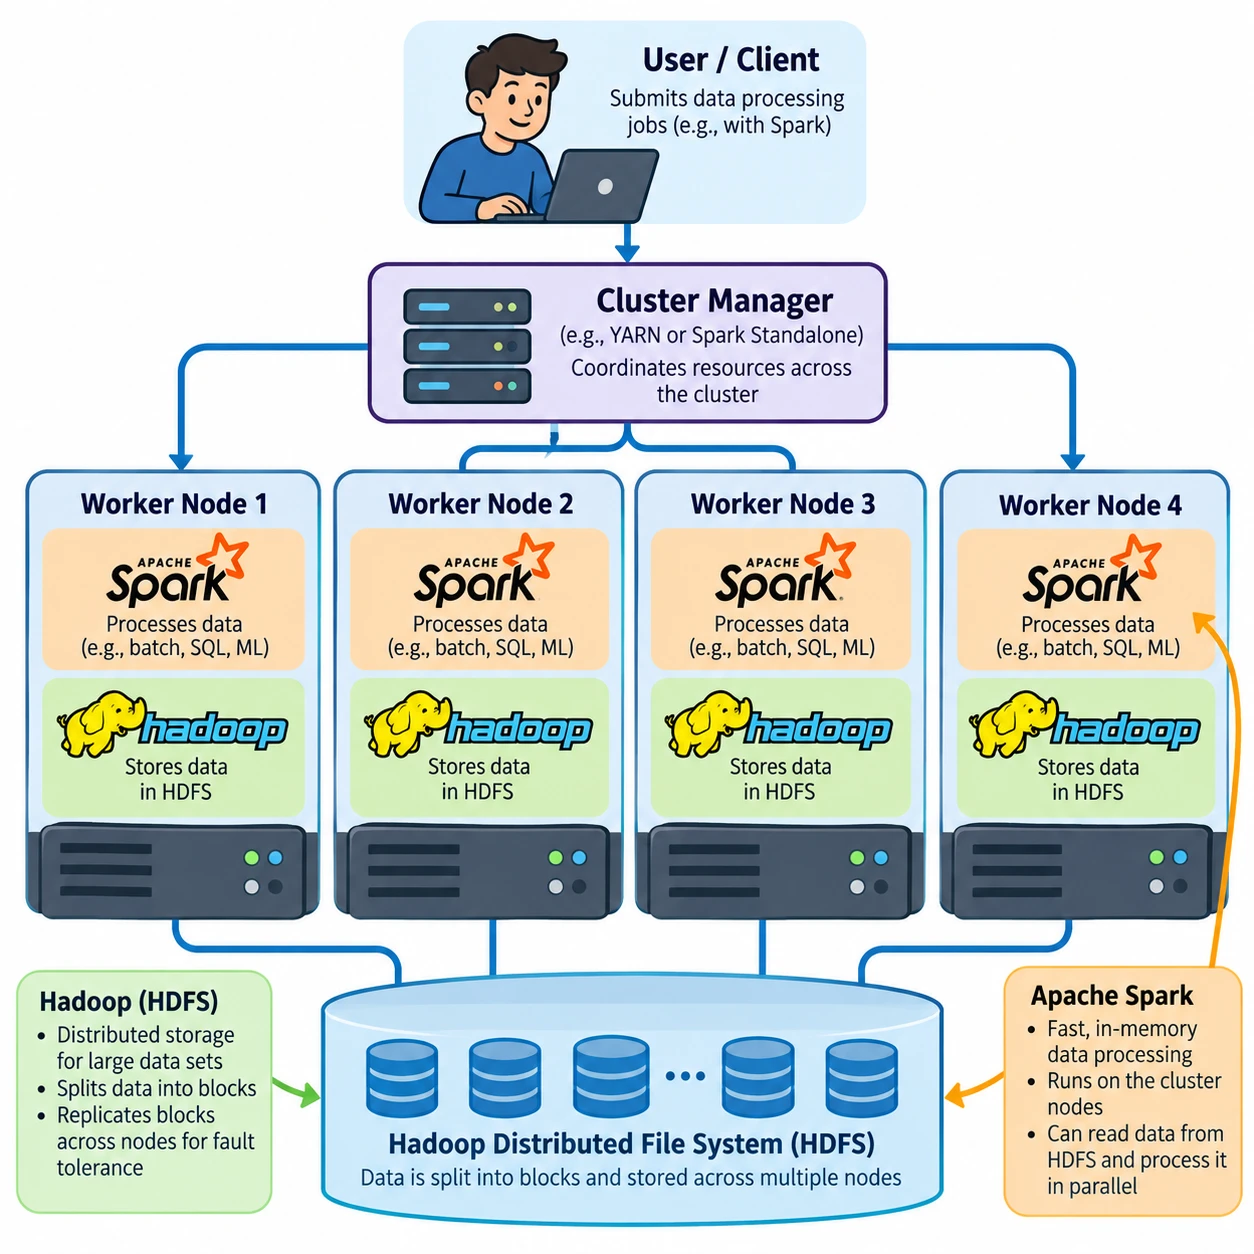
Cuando una empresa reúne millones de registros de ventas, sensores o actividad web, una sola computadora puede quedarse corta para almacenarlos y analizarlos. Apache Hadoop y Apache Spark ayudan a trabajar con esos volúmenes repartiendo tareas entre varios equipos, aunque cumplen funciones distintas y no siempre se necesitan ambos.
En esta guía veremos los conceptos básicos de big data, qué aportan Hadoop y Spark y cómo elegir un punto de partida sin dar por hecho que ya conoces la infraestructura o la programación.
Qué es el big data y por qué requiere sistemas distribuidos
El big data reúne conjuntos de datos cuyo volumen, velocidad o variedad hacen difícil gestionarlos con herramientas tradicionales. Un sistema distribuido almacena o procesa esos datos en varios equipos conectados para repartir el trabajo.
Imagina una biblioteca con más libros de los que caben en una sola sala. En lugar de ampliar indefinidamente esa sala, se organizan varias salas y se crea un catálogo común. Un clúster distribuido aplica una idea parecida: cada máquina aporta almacenamiento y capacidad de cálculo, mientras el sistema coordina las tareas.
Distribuir el trabajo permite procesar grandes conjuntos de datos por partes. Si un equipo falla, algunas plataformas pueden recuperar o repetir tareas, aunque eso depende de la configuración y del tipo de operación. Un clúster también requiere coordinación, supervisión y recursos; repartir los datos no elimina la complejidad.
Estos sistemas suelen abordar tareas de procesamiento por lotes: acumulan datos durante un periodo y los procesan como un conjunto. Por ejemplo, una tienda puede analizar cada noche las ventas del día para calcular inventario y tendencias. Para elegir una solución, conviene considerar cuánto dato hay, con qué frecuencia se actualiza y cuánto tiempo puede esperar el resultado.
Qué es Hadoop y cómo funciona
Apache Hadoop es un ecosistema de software de código abierto para almacenar y procesar datos distribuidos en un clúster. Sus componentes más conocidos son HDFS, YARN y MapReduce, cada uno con una responsabilidad diferente.
HDFS, el sistema de archivos distribuido de Hadoop, guarda archivos grandes divididos en bloques y distribuidos entre máquinas. También mantiene copias configurables de esos bloques para ayudar a tolerar fallos. Esto resulta útil cuando se almacenan grandes volúmenes de datos, pero HDFS no está pensado para sustituir cualquier base de datos ni para responder con rapidez a cada consulta pequeña.
YARN administra los recursos del clúster y coordina la ejecución de aplicaciones. Se puede entender como el encargado de organizar qué tareas usan la memoria y los procesadores disponibles. Así, distintas aplicaciones pueden compartir recursos bajo una gestión común.
MapReduce es un modelo de procesamiento por lotes. Primero, la fase “map” transforma o clasifica partes de los datos; después, “reduce” combina los resultados. Para contar productos vendidos por categoría, por ejemplo, varias máquinas podrían contar sus registros y luego sumar los conteos parciales.
Hadoop se asocia con el almacenamiento distribuido y el procesamiento por lotes, pero su ecosistema ha evolucionado y puede trabajar con otras herramientas. No es correcto reducirlo a MapReduce ni asumir que toda instalación usa exactamente los mismos componentes.
Qué es Apache Spark y qué aporta
Apache Spark es un motor de procesamiento distribuido que permite analizar y transformar datos en un clúster. Puede mantener datos intermedios en memoria para ciertas operaciones repetidas, lo que puede evitar lecturas y escrituras continuas en disco.
Ese enfoque es especialmente útil en flujos de trabajo iterativos, como explorar datos, entrenar modelos de aprendizaje automático o ejecutar varios pasos de análisis sobre el mismo conjunto. Spark también puede leer y escribir datos en distintos sistemas de almacenamiento, incluido HDFS, y ofrece herramientas para trabajar con datos estructurados, consultas y aprendizaje automático.
El procesamiento en memoria no significa que Spark cargue siempre todos los datos en la memoria ni que sea siempre más rápido. Si la memoria disponible es insuficiente, puede necesitar más recursos o recurrir al disco. Para un trabajo sencillo de una sola pasada, la ventaja frente a un procesamiento por lotes basado en disco podría ser menor.
En pocas palabras, Spark aporta un motor flexible para ejecutar trabajos distribuidos; no reemplaza por sí solo todas las funciones de almacenamiento y gestión de recursos asociadas al ecosistema Hadoop.
Hadoop vs. Spark: diferencias principales
La diferencia principal es que Hadoop suele referirse a un ecosistema que incluye almacenamiento y gestión de clúster, mientras que Spark es un motor de procesamiento. Por eso, no siempre son alternativas directas: pueden cubrir distintas partes de una arquitectura de datos.
- Función: HDFS almacena archivos distribuidos; YARN gestiona recursos; MapReduce y Spark procesan datos.
- Enfoque: MapReduce organiza trabajos por lotes en fases; Spark puede aprovechar la memoria para operaciones repetidas y también ejecutar trabajos por lotes.
- Relación: Spark puede ejecutarse con gestores de recursos distintos y leer datos desde varias fuentes. En ciertos entornos puede usar HDFS para almacenamiento y YARN para gestión.
- Elección: depende del tipo de trabajo, las fuentes de datos, la infraestructura existente y las habilidades del equipo, no solo de cuál tecnología parece más nueva.
Una forma sencilla de decidir es separar tres preguntas: dónde se guardan los datos, quién administra los recursos y qué motor ejecuta el cálculo. Hadoop puede aportar respuestas a las dos primeras y también ofrecer MapReduce; Spark se centra principalmente en la tercera. Elegir Spark por su procesamiento en memoria implica planificar la memoria y los recursos; elegir MapReduce puede encajar en lotes claros, aunque ciertos flujos iterativos resulten menos cómodos.
Para conocer mejor cada proyecto, puedes consultar la documentación oficial de Apache Hadoop y Apache Spark. Las páginas explican componentes, capacidades y opciones de uso con más detalle.
Casos de uso de Hadoop y Spark
Hadoop y Spark se utilizan para almacenar, transformar y analizar datos que superan lo práctico de procesar en una sola máquina. La herramienta adecuada depende de la forma de los datos, la frecuencia del análisis y la infraestructura disponible.
HDFS puede servir como almacenamiento distribuido para grandes archivos, por ejemplo, registros históricos de aplicaciones o datos recopilados por sensores. MapReduce puede procesar esos datos por lotes para generar un resumen diario, como el número de errores por servicio.
Spark puede resultar conveniente cuando un análisis requiere varios pasos o necesita recalcular resultados a medida que se exploran los datos. Un equipo podría limpiar registros de compras, agruparlos por región y preparar un conjunto para análisis posterior. También puede utilizar Spark para transformaciones a gran escala y determinados flujos de aprendizaje automático.
En una arquitectura combinada, una organización puede guardar datos en HDFS y ejecutar procesos de Spark que los lean y transformen. Sin embargo, no todas las tareas necesitan un clúster: un conjunto pequeño suele ser más fácil y económico de explorar con herramientas locales. Antes de adoptar una plataforma distribuida, comprueba que el volumen o la carga de trabajo justifiquen su complejidad operativa.
Cómo empezar con Hadoop y Spark
Para empezar con Hadoop y Spark, aprende primero cómo se representan y transforman los datos, practica programación básica y después prueba tareas pequeñas antes de pasar a un clúster. Esta ruta ayuda a entender los conceptos sin confundir herramientas con fundamentos.
- Afianza las bases: familiarízate con archivos, tablas, formatos de datos y operaciones como filtrar, agrupar y combinar registros. Aprende también qué significa dividir un trabajo entre varias máquinas.
- Practica programación: elige un lenguaje compatible con las herramientas que quieras explorar y realiza ejercicios sencillos con datos pequeños. No hace falta comenzar administrando infraestructura.
- Resuelve una tarea concreta: por ejemplo, cuenta eventos por categoría en un archivo de muestra. Primero entiende la entrada, la transformación y el resultado esperado.
- Compara enfoques: observa cómo se distribuye el trabajo y qué papel tendrían almacenamiento, gestor de recursos y motor de procesamiento. Luego prueba Spark y conoce los componentes de Hadoop según tu objetivo.
Un error frecuente es aprender comandos de instalación antes de comprender el flujo de datos. Puede hacer perder tiempo en dependencias y configuración sin aclarar qué problema resuelve cada componente. Empieza por una tarea medible y aumenta el tamaño o la complejidad gradualmente. En un proyecto real, también tendrás que considerar seguridad, formatos, costes y operación del clúster.
Preguntas frecuentes sobre Hadoop y Spark
Hadoop y Spark pueden complementarse, pero no son equivalentes. Las respuestas siguientes resumen cuándo se relacionan y qué conviene aprender primero.
¿Hadoop y Spark son tecnologías competidoras?
No necesariamente. Hadoop es un ecosistema que incluye HDFS y YARN, mientras que Spark es un motor de procesamiento. Ambos pueden coincidir en una arquitectura: Spark procesa datos almacenados en HDFS y puede usar YARN para gestionar recursos.
¿Spark necesita Hadoop para funcionar?
No. Spark puede ejecutarse sin Hadoop y trabajar con diferentes sistemas de almacenamiento y gestores de recursos. Hadoop puede ser una opción si una organización ya usa HDFS o YARN, pero no es un requisito universal.
¿Cuál conviene aprender primero?
Si empiezas desde cero, aprende primero los fundamentos de datos y programación. Después, elige Spark si tu interés principal es transformar y analizar datos distribuidos; estudia Hadoop si quieres entender almacenamiento como HDFS y gestión de clúster con YARN.
¿Se pueden usar Hadoop y Spark juntos?
Sí. Una configuración posible es almacenar datos en HDFS, administrar recursos con YARN y ejecutar el procesamiento con Spark. La combinación depende de la infraestructura y de las necesidades del proyecto; no siempre hace falta instalar ambos.